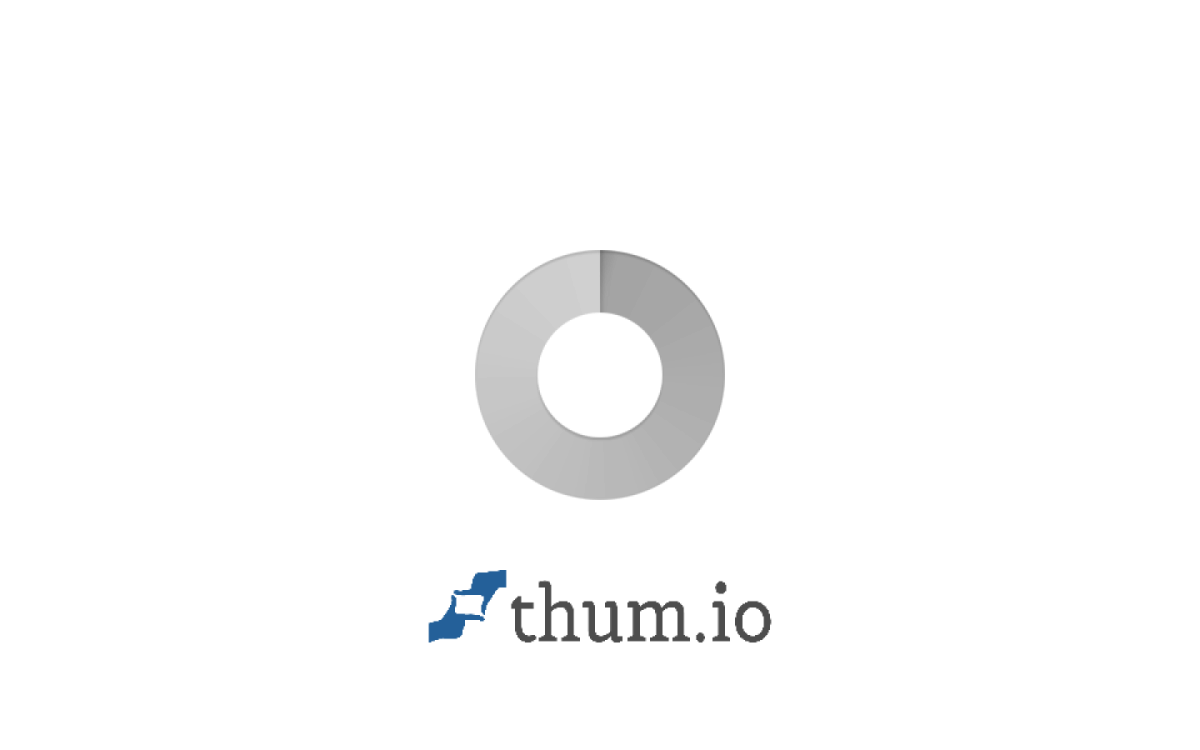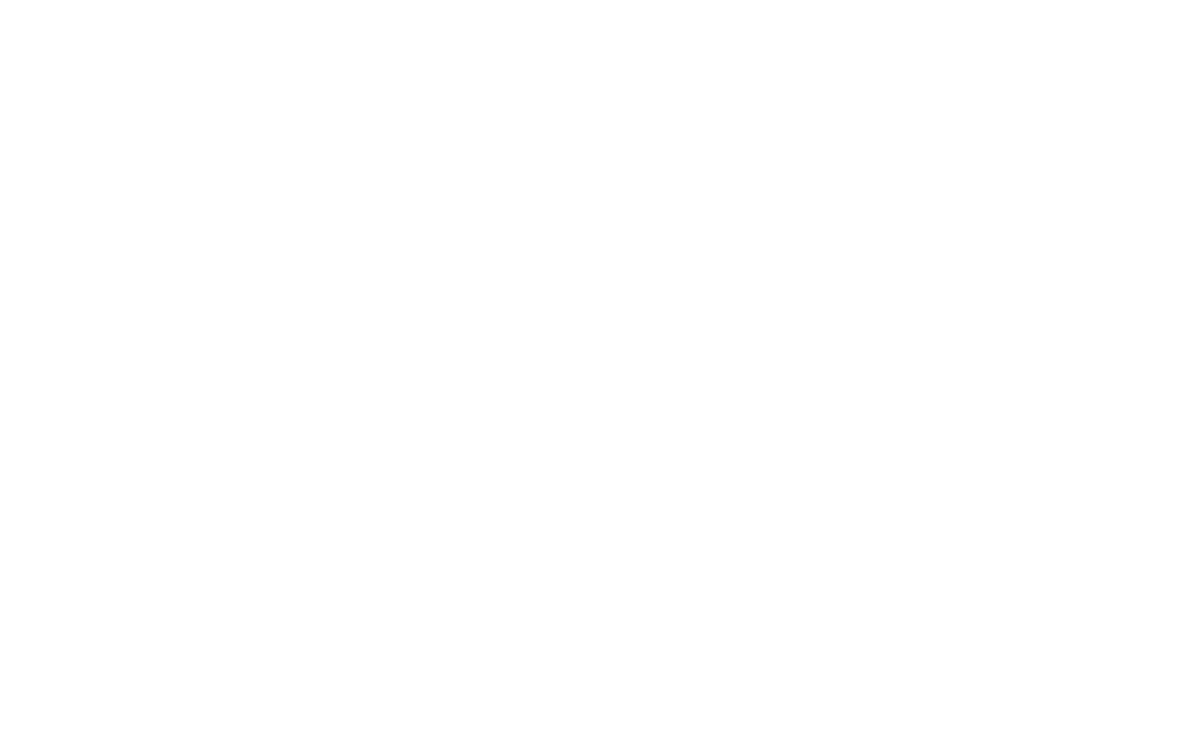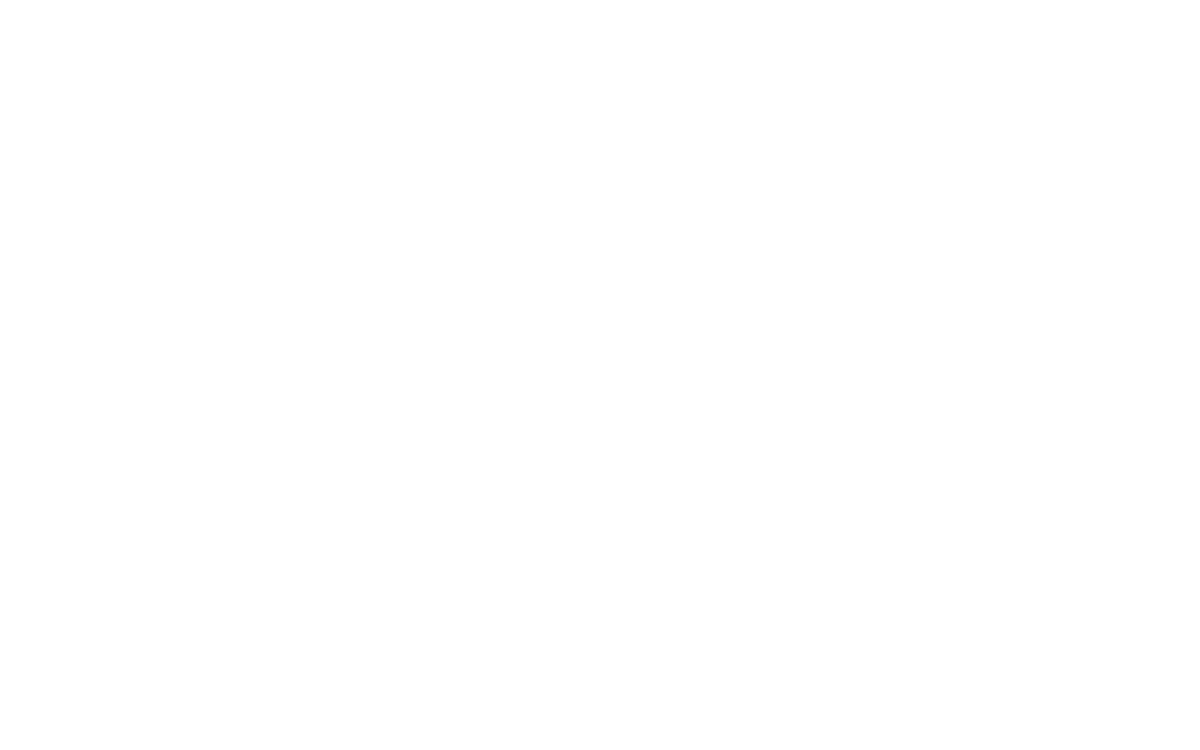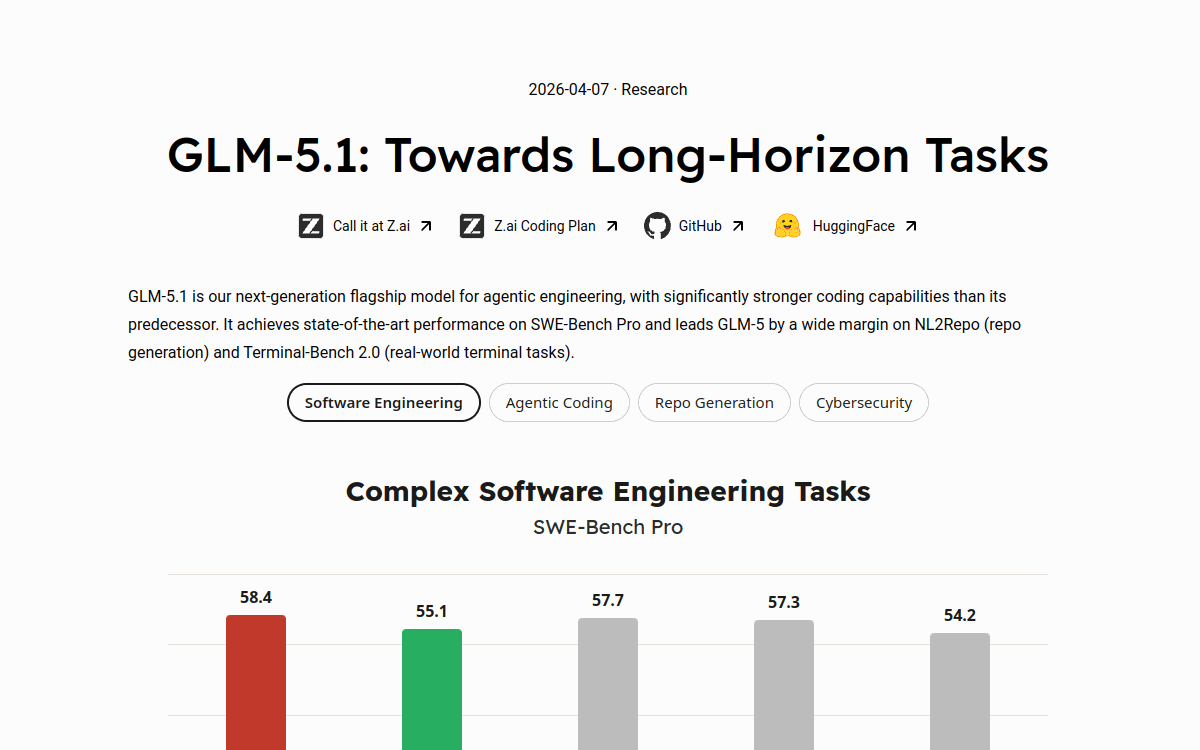
GLM-5.1 est le modèle IA open source phare de Z.ai, conçu pour l’ingénierie agentique et le développement logiciel long-horizon. Architecture MoE avec 754 milliards de paramètres, contexte de 200K tokens et capacité à travailler de manière autonome pendant plus de huit heures sur une tâche, GLM-5.1 dépasse GPT-5.4 et Claude Opus 4.6 sur SWE-Bench Pro. Disponible sous licence MIT, le modèle s’utilise via API Z.ai, OpenRouter, NVIDIA NIM ou en self-hosting.
Qu'est-ce que GLM 5.1 ?
L'essentiel
GLM-5.1 est le modèle phare de la lignée GLM (General Language Model) développée par Z.ai. Il s’inscrit dans la continuité de la suite GLM-4 mais introduit plusieurs ruptures techniques majeures. L’architecture est une Mixture of Experts dite Dense-Sparse-Alternating, totalisant 754 milliards de paramètres avec une activation partielle qui maintient des coûts d’inférence raisonnables. Le modèle supporte 200 000 tokens en contexte et 128 000 tokens en sortie. Il est conçu spécifiquement pour les tâches d’ingénierie agentique, le développement logiciel long-horizon, la génération de code, le raisonnement étendu et l’usage d’outils. La licence MIT permet l’usage commercial, le fine-tuning et le déploiement self-hosted sans restriction.
Fonctionnalités principales
GLM-5.1 propose plusieurs fonctionnalités différenciantes. Le mode pensée explicite, ou thinking mode, permet au modèle de raisonner pas à pas avant de produire la réponse finale, ce qui améliore la qualité sur les tâches complexes. Le function calling natif autorise l’invocation d’outils externes, le structured output garantit des sorties JSON fiables, et le context caching réduit les coûts sur les longues conversations. L’intégration MCP est supportée nativement, ce qui facilite l’usage du modèle dans des architectures d’agents standardisées. Côté performance, GLM-5.1 obtient un score de 58.4 sur SWE-Bench Pro, dépassant GPT-5.4, Claude Opus 4.6 et Gemini 3.1 Pro. Sur le benchmark KernelBench Level 3, le modèle atteint un speedup géométrique de 3.6x, contre 1.49x pour torch.compile. Le modèle est disponible via plusieurs canaux : API Z.ai, NVIDIA NIM, OpenRouter, Vercel AI Gateway, Hugging Face pour les poids et la communauté GitHub pour les outils.
Cas d'usage
Une équipe dev utilise GLM-5.1 pour automatiser des refactorings massifs sur des codebases complexes, en confiant au modèle des tâches qui demandent plusieurs heures de raisonnement. Une startup IA s’en sert pour construire des agents autonomes capables de planifier, coder et tester du logiciel de bout en bout. Un chercheur en optimisation GPU exploite les capacités KernelBench du modèle pour générer des kernels CUDA performants. Une organisation soucieuse de souveraineté déploie GLM-5.1 en self-hosting pour traiter des données sensibles sans dépendre d’un fournisseur externe. Un éditeur de produits IA intègre GLM-5.1 comme moteur de raisonnement long-horizon dans son agent vertical. Enfin, des équipes de recherche universitaire exploitent l’ouverture totale du modèle pour étudier le comportement des agents en exécution autonome.
Avantages
Le bénéfice principal de GLM-5.1 est la combinaison rare entre performance frontière et ouverture totale. Les équipes obtiennent un modèle au niveau des leaders propriétaires sans verrou contractuel, sans dépendance fournisseur et sans limite de fine-tuning. Le contexte étendu de 200K tokens débloque des cas d’usage sur de très grandes codebases sans découpage manuel. La capacité d’exécution autonome long-horizon réduit la supervision humaine nécessaire pour les tâches complexes. La licence MIT autorise les usages commerciaux les plus exigeants, y compris dans des produits SaaS distribués mondialement.
Tarifs
GLM-5.1 est gratuit sous licence MIT pour le téléchargement des poids et le self-hosting. L’usage via API Z.ai, OpenRouter ou NVIDIA NIM est facturé à l’usage, avec des tarifs très compétitifs comparés aux modèles propriétaires équivalents. Z.ai propose également un chat gratuit pour tester le modèle directement. Pour le self-hosting, l’investissement principal porte sur l’infrastructure GPU nécessaire pour servir un modèle MoE de cette taille. Plusieurs partenaires cloud proposent des inférences managées à des tarifs prévisibles, adaptés aux équipes qui ne veulent pas gérer l’infrastructure.
Conclusion
GLM-5.1 s’impose comme le modèle open source à battre dans la catégorie des modèles d’ingénierie agentique. Performance frontière, contexte étendu, exécution autonome long-horizon et licence MIT en font une option exceptionnelle pour les équipes dev, les startups IA et les organisations souveraines. Les barrières restantes concernent surtout la complexité d’opération à grande échelle.